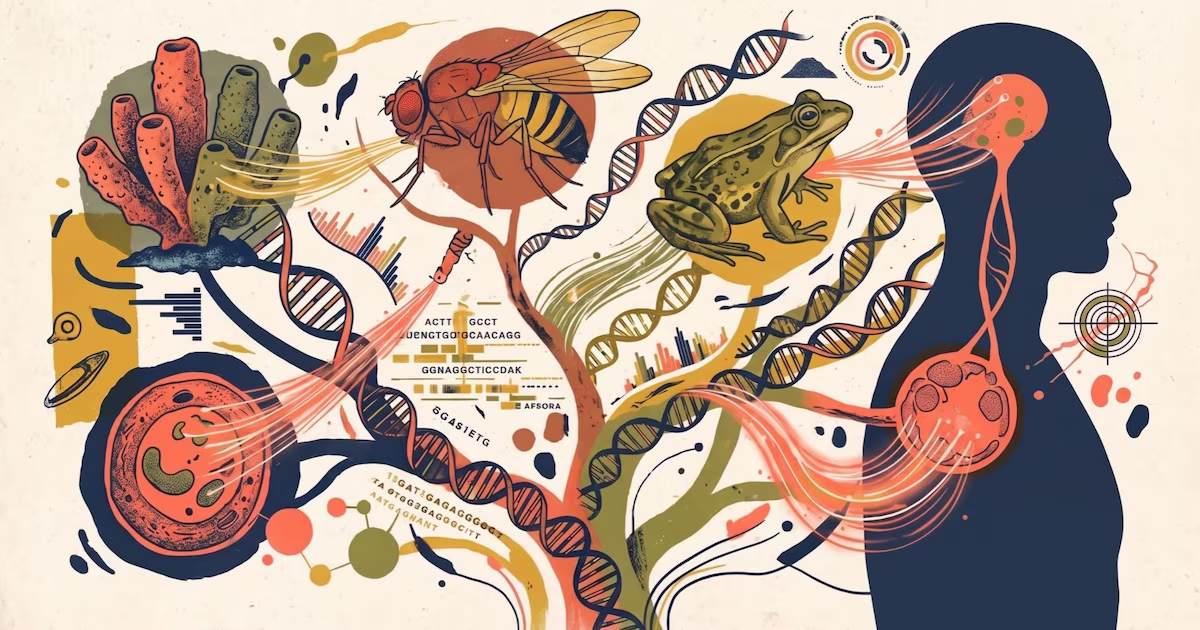
Un equipo de la Facultad de Medicina de la Universidad de Stanford desarrolló TranscriptFormer, una inteligencia artificial entrenada con datos de 112 millones de células pertenecientes a 12 especies distintas. Su objetivo es comparar biologías celulares y detectar conexiones entre organismos, enfermedades y posibles enfoques terapéuticos basados en células.
Este avance representa la segunda generación de modelos en la línea de lo que se conoce como embedding celular universal, una idea que asigna a cada célula una coordenada dentro de un espacio matemático común para facilitar la comparación entre especies.
La base de datos integrada contiene ejemplos de levaduras unicelulares, seres humanos y otros mamíferos, además de ratones, conejos, pollos, peces cebra, la mosca de la fruta, la rana africana de uñas, el parásito causante de la malaria, erizos de mar, esponjas y Caenorhabditis elegans, un nematodo microscópico. Los datos provienen de atlas celulares, repositorios que clasifican células y tejidos a partir de los genes que expresan.
La investigación se publicó en dos trabajos difundidos en Nature y Science. Según explican los autores, el genoma contiene las instrucciones de la vida, pero la identidad funcional de una célula depende de su patrón de expresión génica, es decir, qué genes se activan en cada momento. Ese conjunto de expresiones permite distinguir entre tipos celulares, entre células sanas y enfermas, y entre especies.
Por ejemplo, una célula beta del páncreas expresa genes vinculados a la insulina y a la gestión del almacenamiento y liberación de esa hormona; los linfocitos B producen anticuerpos para defenderse de enfermedades; y una célula de la piel puede activar genes relacionados con el pelo o con la pigmentación.
Con tantos genes y células, la cantidad de información supera la capacidad de análisis manual. El profesor Stephen Quake, bioingeniero de Stanford y coautor principal de los estudios, subrayó que “la mente humana no puede pensar en todos estos genes a la vez” y que estos modelos permiten abordarlo. “Los algoritmos son herramientas para entender datos extremadamente complejos que los seres humanos no podemos abarcar”, añadió.
TranscriptFormer adopta un esquema de aprendizaje similar al de grandes modelos de lenguaje, como ChatGPT: en lugar de palabras, el sistema aprende a partir de valores de expresión génica, mediante un proceso de predicción que rellena información faltante. El resultado es un espacio matemático único donde se ubican y se comparan células de distintas especies, permitiendo estudiar sus similitudes y diferencias a gran escala.
Entre los hallazgos preliminares, el modelo aporta insights sobre la evolución de las neuronas al contrastar células de diferentes linajes, aunque los investigadores señalan que todavía quedan preguntas por resolver y que estos hallazgos deben ser explorados con más datos y experimentación.