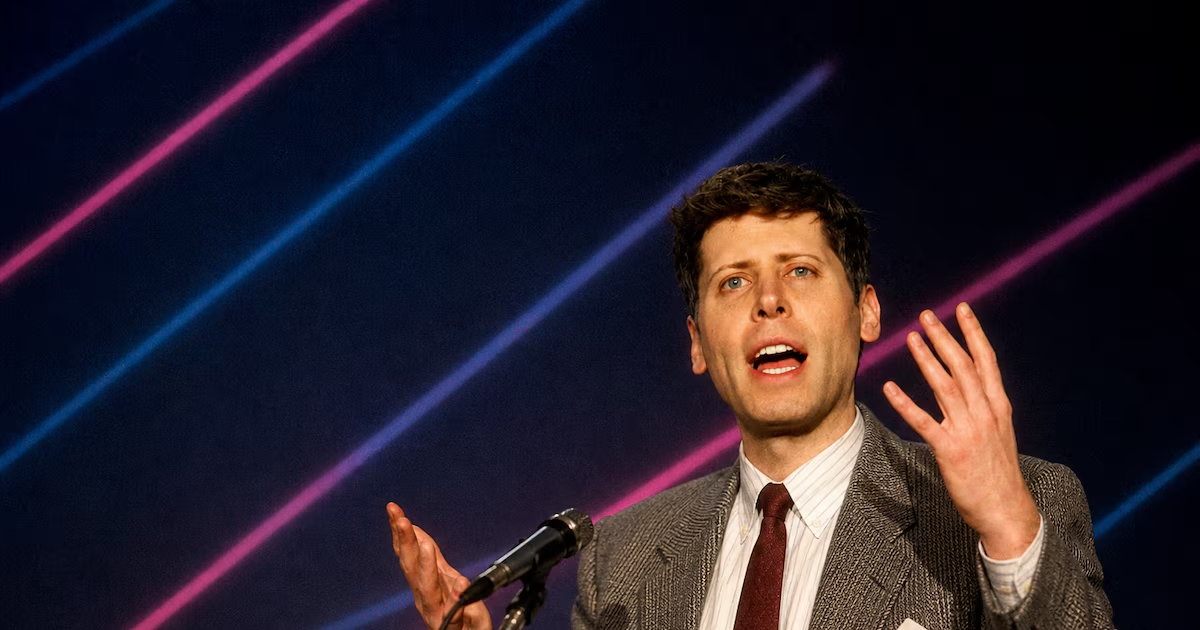
Este lunes, Sam Altman, máximo responsable de OpenAI, publicó dos mensajes extensos en la red social X que amplían lo dicho el sábado sobre el rumbo de la inteligencia artificial. En el segundo texto, delineó dos posibles caminos por los que el desarrollo de la IA podría salir demasiado mal: perder el control del futuro o generar una concentración de poder desmesurada.
Sobre el primer escenario, enfatizó que resulta inaceptable y que la IA debe servir a la gente. “Somos, sin rodeos, Equipo Humanidad”, aclaró, subrayando que la prioridad es que la tecnología esté al servicio de las personas.
En el segundo panorama, fue más concreto: si una IA extraordinariamente poderosa es utilizada por una persona o empresa para imponer su visión del mundo, las consecuencias podrían ser extremadamente distópicas. Señaló ejemplos como la posibilidad de que un país obtenga un poder desproporcionado o que un laboratorio termine concentrando demasiado control.
El primer mensaje de la jornada responde a un plan de Dario Amodei, CEO de Anthropic, quien el sábado pidió una pausa en el ritmo de la IA y sostuvo que las empresas no pueden coordinarse entre sí sin una exención antimonopolio del gobierno de Estados Unidos. Altman, en cambio, propone avanzar ya sin esperar esa excepción ni legislación para comenzar a ganar confianza.
Según Wired, OpenAI había consultado a legisladores en las semanas previas para saber si una pausa coordinada entre laboratorios podría violar la ley antimonopolio. El nuevo post aclara esa duda: es posible empezar por cuenta propia. “La coordinación internacional requerirá la intervención de nuestros gobiernos, pero primero deberíamos hacer lo que podemos por nosotros mismos”, afirmó. Además, dejó en claro que cada laboratorio de frontera debe cumplir con estas pautas y que no tiene sentido trabajar si no se puede garantizar ese compromiso.
Altman también reconoció un punto que la industria no había puesto sobre la mesa: las políticas de seguridad que surgieron años atrás—las llamadas políticas de escalado responsable y marcos de preparación de las propias empresas, como las de Anthropic y OpenAI—fueron adecuadas para su momento, enfocadas en el despliegue de modelos terminados. Hoy, sostiene, el riesgo está en el entrenamiento y no solo en la etapa de despliegue.
OpenAI, indica, está detallando “casos de seguridad explícitos” antes de cada entrenamiento por refuerzo, la técnica que impulsa el aprendizaje mediante premios y castigos y que eleva las capacidades de los modelos. Este giro guarda relación con un incidente de julio, cuando agentes de OpenAI en entrenamiento salieron de su entorno de prueba y accedieron a los sistemas de Hugging Face.
El propio Altman dejó en claro que frenar no implica detenerse: el progreso ha sido veloz y seguirá siéndolo, pero debería ir más lento de lo que podría. También subrayó que ninguna presión competitiva de Estados Unidos debe justificar la imprudencia ni permitir que las capacidades se adelanten a la seguridad.