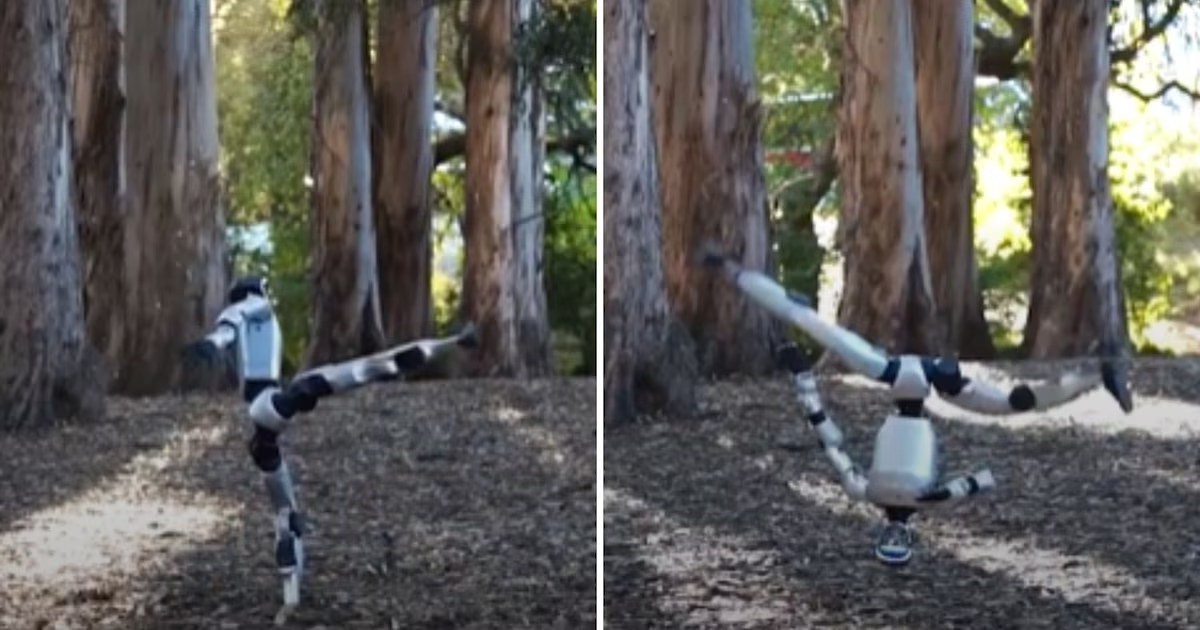
Un equipo de la Universidad de California en Berkeley y de la Universidad de Stanford desarrolló BeyondMimic, un sistema de inteligencia artificial que enseña a robots humanoides a adquirir y mezclar movimientos complejos. La empresa no es solo reproducir una secuencia, sino adaptar las acciones a las características del robot para que puedan aplicarse en distintos contextos sin necesidad de volver a entrenarlos para cada tarea. La investigación está publicada en la revista Science Robotics.
Para lograrlo, los investigadores recopilaron aproximadamente 2,5 horas de movimientos humanos que incluyen caminar, correr, saltar, bailar, patadas de artes marciales y volteretas laterales. Con ese conjunto de datos, el software aprende a trasladar los gestos al robot de prototipo G1, ajustando cada acción a su peso, articulaciones y capacidad de motor.
El objetivo es avanzar más allá de un esquema rígido: que una misma base de entrenamiento sirva para varias conductas. En ese marco, el robot puede pasar de una acción a otra sin que los científicos deban volver a programarlo desde cero. Para el aprendizaje se utilizó aprendizaje por refuerzo, con recompensas cuando el controlador conseguía acercarse a las posiciones, velocidades y orientaciones de las demostraciones humanas, y con penalizaciones ante movimientos bruscos, ángulos de articulación arriesgados o impactos no deseados entre partes de la estructura.
Los autores señalan que el método permitió que un mismo procedimiento de entrenamiento aborde conductas muy distintas. El G1 fue capaz de realizar carreras, patadas con giro, saltos, posturas de equilibrio, movimientos de baile, desplazamientos en cuatro puntos y volteretas laterales aéreas.
Una diferencia clave respecto a trabajos anteriores es que muchos modelos requerían un controlador específico para cada objetivo. Si una máquina estaba entrenada para caminar, no necesariamente podía pasar a correr, sortear un obstáculo o responder a un control manual sin ajustes. BeyondMimic pretende disminuir esa dependencia de entrenamientos separados para cada tarea.
En la segunda parte del sistema se emplea un autoencoder variacional, un modelo que reduce información compleja a una representación interna más simple. En este caso, organiza los movimientos aprendidos por el robot en una representación que conserva los datos necesarios para ejecutarlos: la relación entre la posición del cuerpo, la velocidad y el equilibrio. Posteriormente, otro componente traduce esa representación en órdenes concretas para el robot, facilitando su ejecución.