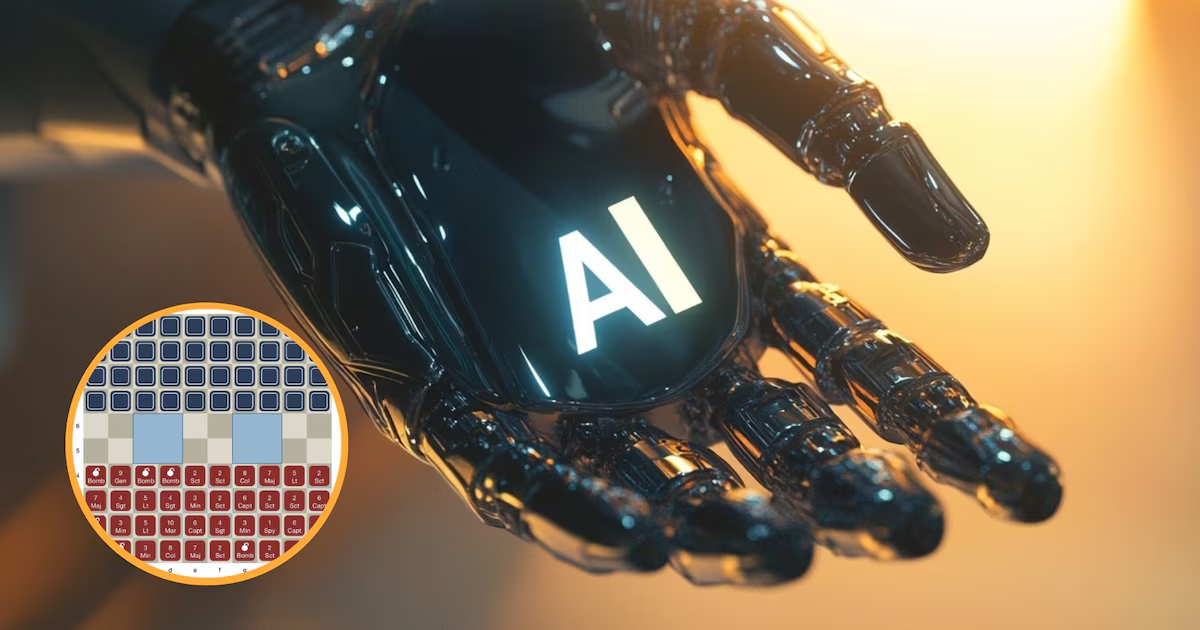
Investigadores de las/los más destacados centros académicos —MIT, Carnegie Mellon, Stanford y la Universidad de Nueva York— desarrollaron un sistema de inteligencia artificial denominado Ataraxos que logró vencer por primera vez al mejor jugador humano de Stratego, un juego de guerra de mesa con piezas ocultas que había resistido intentos de automatización previos.
En una serie de 20 partidas, Ataraxos derrotó a Pim Niemeijer, neerlandés reconocido como el máximo laureado de la disciplina, con un historial de 15 victorias, 1 derrota y 4 empates. El resultado se publicó en la revista Nature.
Lo notable no es solo la victoria, sino el costo de entrenamiento. El equipo indica que la inversión para entrenar al sistema fue inferior a 8.000 dólares: una semana con 16 GPUs Nvidia H100, más cuatro días adicionales con un segundo bloque de cuatro GPUs para entrenar una red que anticipa las jugadas del rival.
Para contrastar, mencionan a DeepNash, el sistema que Google DeepMind dio a conocer en 2022. Según los autores, ese proyecto requirió entre dos y tres meses de entrenamiento sobre 1.024 nodos TPU, y su costo estimado en valores actuales oscilaría entre 3 y 4,5 millones de dólares.
DeepNash ya había mostrado rendimiento destacado al situarse entre los tres mejores de Gravon en 2022, pero no logró superar de forma sostenida a jugadores de élite. En cambio, Ataraxos acumula un historial de 39 victorias y 2 derrotas frente a rivales de primer nivel en el campeonato mundial de Stratego, además del resultado frente a Niemeijer.
Stratego se distingue de otros juegos de mesa como el ajedrez o el Go porque, aunque cada bando puede ver la posición de las 40 piezas contrarias, no se sabe qué pieza es cuál. Esa ambigüedad genera un abanico enorme de posibles configuraciones y había frenado durante años la posibilidad de obtener un rendimiento por encima del humano.
“Con Stratego hay una explosión de universos posibles a los que hay que enfrentarse. Las técnicas de IA usadas en juegos con información completa no escalan aquí”, señaló Gabriele Farina, profesor asistente del MIT y coautor del estudio, a MIT News.
La estrategia del equipo combinó aprendizaje por refuerzo —el sistema aprende jugando contra sí mismo millones de veces— con una red de creencias que estima, en cada turno, cuál es la disposición más probable del tablero rival. “En lugar de adivinar a ciegas, usamos planificación en el momento de decidir para hallar el estado más plausible”, añadió Farina.
Además, el diseño de Ataraxos buscó evitar la previsibilidad. Durante el entrenamiento, se empujó al modelo a variar sus configuraciones y movimientos para evitar que una estrategia temprana explo-table a su rival, algo especialmente ventajoso en Stratego, donde la sorpresa puede marcar la diferencia.